모든 문서를
AI가 믿고 쓰는 형식으로.
Luminir Document Parser는 르몽이 만든 설치형 문서 파서입니다. 한글, PDF, 오피스 등 다양한 문서 및 이미지를 제목과 표, 읽기 순서를 살린 HTML과 JSON으로 바꿉니다. 온프레미스로 설치 시 데이터가 기관 밖으로 나가지 않습니다.
Luminir Document Parser는 HWP·HWPX, PDF, 워드, 파워포인트, 엑셀, 이미지 등을 지원합니다.
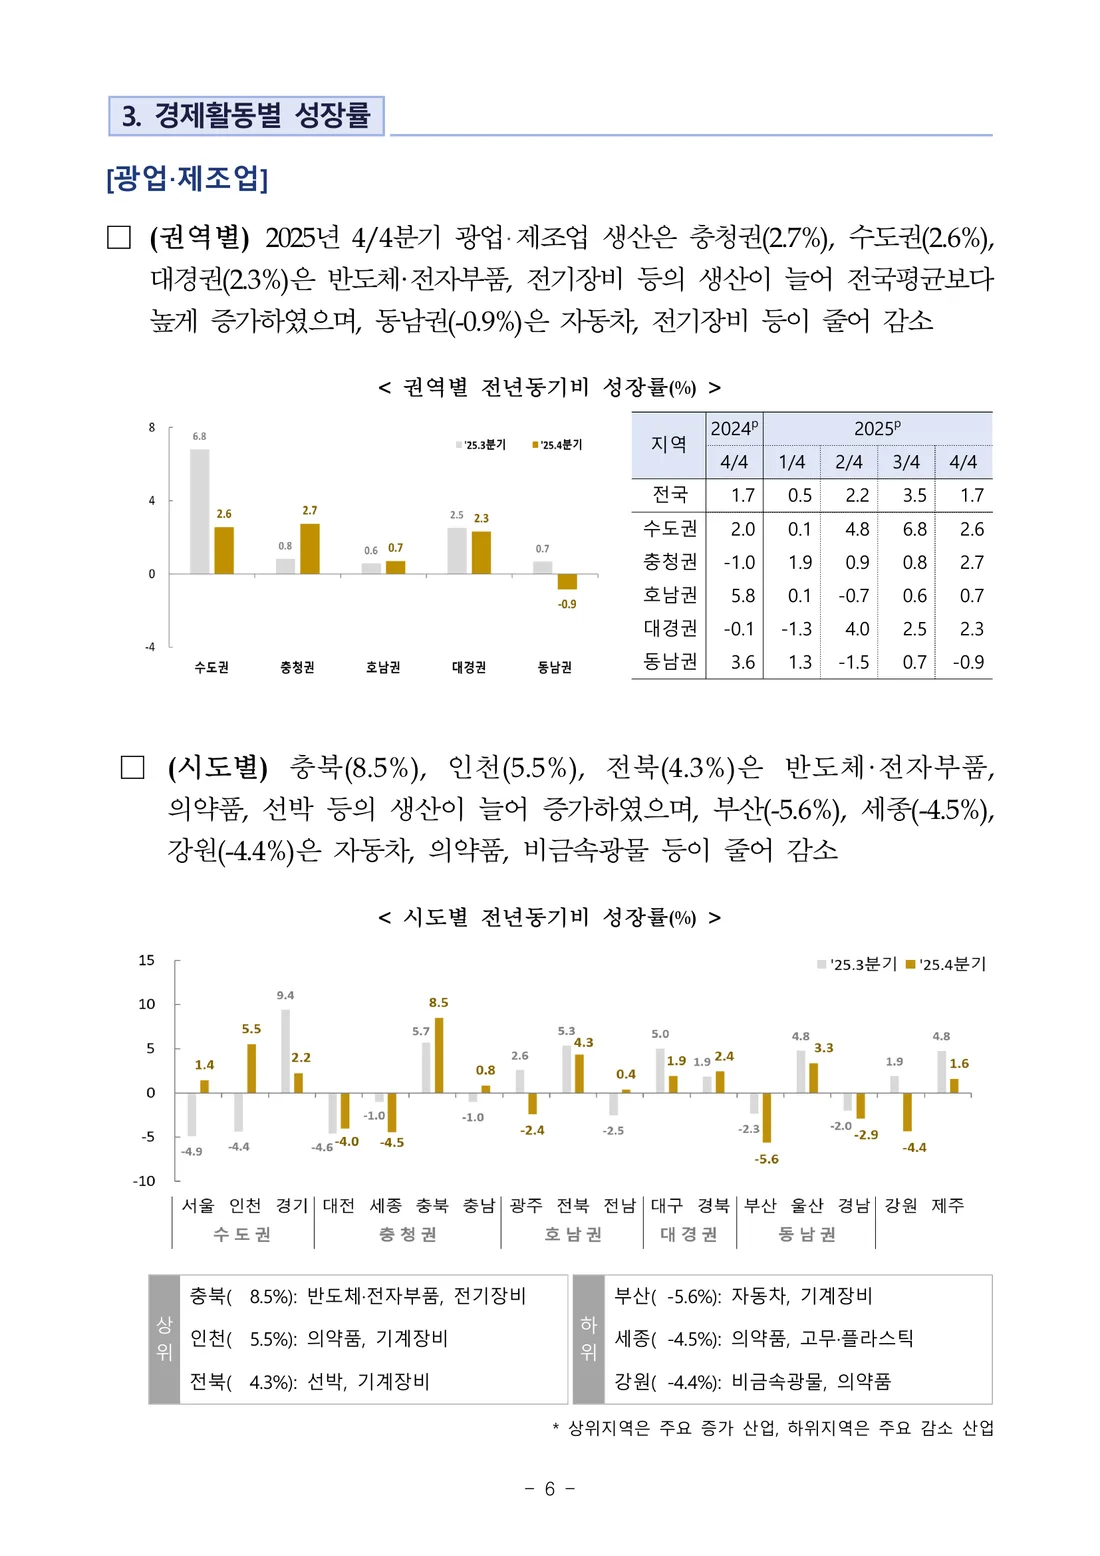
3. 경제활동별 성장률
[광업·제조업]
□ (권역별) 2025년 4/4분기 광업·제조업 생산은 충청권(2.7%), 수도권(2.6%), 대경권(2.3%)은 반도체·전자부품, 전기장비 등의 생산이 늘어 전국평균보다 높게 증가하였으며, 동남권(-0.9%)은 자동차, 전기장비 등이 줄어 감소
< 권역별 전년동기비 성장률(%)>
| 25.3분기 | 25.4분기 | |
| 수도권 | 6.8 | 2.6 |
| 충청권 | 0.8 | 2.7 |
| 호남권 | 0.6 | 0.7 |
| 대경권 | 2.5 | 2.3 |
| 동남권 | 0.7 | -0.9 |
| 지역 | 2024 | 2025 | |||
| 4/4 | 1/4 | 2/4 | 3/4 | 4/4 | |
| 전국 | 1.7 | 0.5 | 2.2 | 3.5 | 1.7 |
| 수도권 | 2.0 | 0.1 | 4.8 | 6.8 | 2.6 |
| 충청권 | -1.0 | 1.9 | 0.9 | 0.8 | 2.7 |
| 호남권 | 5.8 | 0.1 | -0.7 | 0.6 | 0.7 |
| 대경권 | -0.1 | -1.3 | 4.0 | 2.5 | 2.3 |
| 동남권 | 3.6 | 1.3 | -1.5 | 0.7 | -0.9 |
타사 제품들과의 차이점
일반 텍스트 추출기는 글자만 꺼내고 표와 단 구성은 버립니다.
이렇게 만든 데이터로는 검색이 빗나가고 AI 답변도 틀리기 쉽습니다.
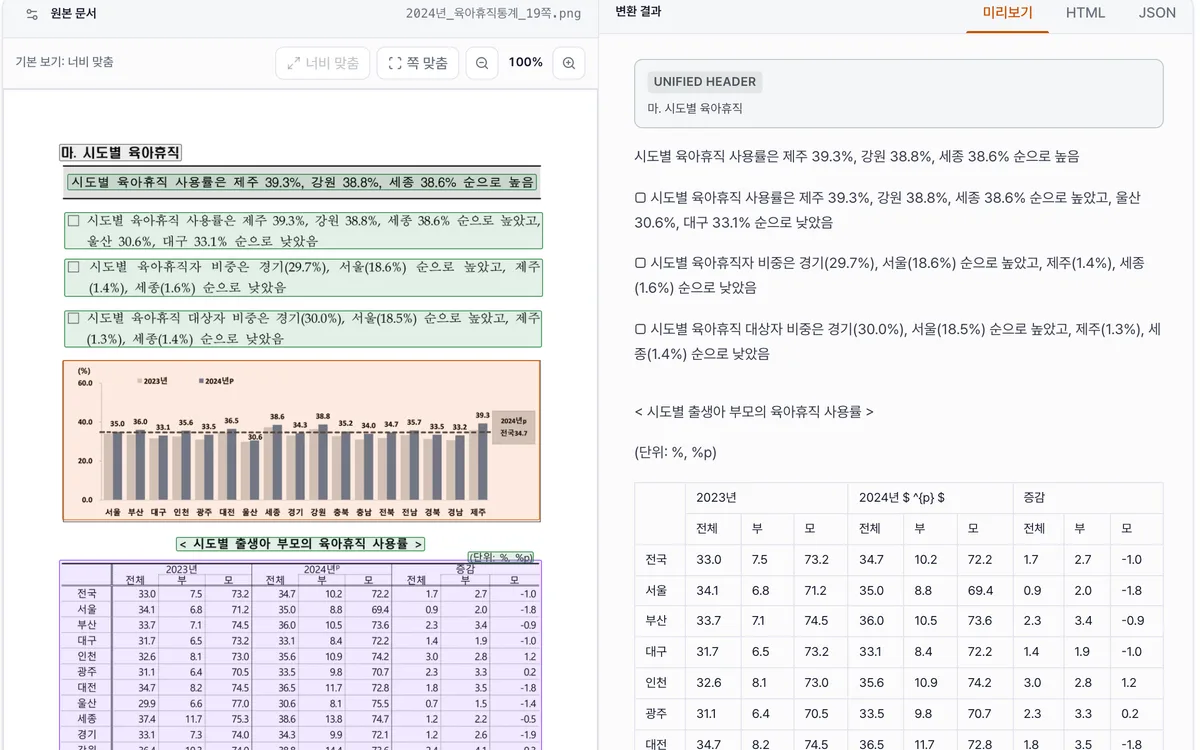
변환 결과를 원본과 나란히 확인합니다
변환이 맞았는지 개발자가 아니어도 화면에서 바로 확인할 수 있습니다.
고객의 정보를 안전하게 보호합니다
인터넷이 끊긴 폐쇄망에서도 사용 가능합니다.
- 온프레미스, 폐쇄망 설치NVIDIA GPU가 있는 리눅스 서버에 컨테이너로 설치합니다.
- 외부 AI 서비스 없이 운영레이아웃 분석과 인식 모델을 기관 서버에 함께 설치해, 문서가 기관 밖으로 나가지 않아 고객의 정보를 보호합니다.
- 권한과 기록관리자와 사용자 권한을 나누고, 원본 문서는 암호화해 저장합니다. 누가 언제 문서를 다뤘는지에 대한 기록도 남습니다.
- 업무 시스템REST API 연동
- Luminir Document Parser인식 모델 포함, GPU 서버
- 결과 저장소HTML과 JSON 보관
- RAG 검색 시스템HTML과 JSON 수신
문서를 바꾸는 네 단계
문서 받기
한글, PDF, 워드, 파워포인트, 엑셀, 이미지 12종 파일을 미리 바꾸지 않고 그대로 받습니다.
레이아웃 분석
쪽마다 제목과 본문, 표, 그림, 머리말이 어디 있는지 찾고 읽을 순서를 정합니다.
영역별 인식
본문은 글자로 읽고, 표는 병합 셀까지 행과 열 구조로 읽습니다. PDF와 스캔 문서의 수식은 LaTeX 형식으로 꺼내고, 그래프와 플로우차트는 담긴 내용을 표로 정리합니다.
결과 내보내기
결과는 HTML과 JSON으로 받습니다. JSON에는 요소마다 종류, 쪽 번호, 위치 좌표가 들어갑니다(엑셀은 시트와 셀 범위). 머리말과 쪽 번호는 따로 표시돼 있어 필요 없으면 걸러 내면 됩니다.
공개 벤치마크 정확도
점수가 1.0에 가까울수록 정답과 가깝습니다.
- 0.914읽기 순서와 표, 제목을 합친 종합 점수공개 1위 점수(0.907)보다 높음
읽기 순서, 표, 제목 세 항목 모두 공개 1위보다 높습니다.
opendataloader-bench 순위 (높은 순) 순위 엔진 점수 1 Luminir Document Parser 0.914 2 opendataloader (hybrid) 0.907 3 상용 파서 A 0.885 4 docling 0.882 5 marker 0.861 6 unstructured (hi_res) 0.841 opendataloader-bench 공개 리더보드 상위 5개와 같은 채점 코드로 잰 Luminir 점수(자체 측정)를 함께 놓았습니다. - 0.759글자와 표, 읽기 순서, 제목, 위치를 합친 종합 점수설치형 엔진 중 최고 점수
관보, 통계표, 보고서 같은 한국어 실제 문서로 잰 점수입니다. 요소 위치 점수는 0.976입니다.
KoOCR-Bench 순위 (높은 순) 순위 엔진 점수 1 상용 파서 B (클라우드 API) 0.773 2 Luminir Document Parser 0.759 3 상용 파서 C 0.755 4 mineru-4 (advanced) 0.752 5 paddleocr-vl-1.6 0.748 6 unlimited-ocr 0.745 KoOCR-Bench 공개 결과표(2026-10-05) 상위 5개와 같은 채점 코드로 잰 Luminir 점수(자체 측정)를 함께 놓았습니다. - 0.962표 구조와 내용이 정답과 얼마나 같은지(TEDS)공개 리더보드 1위 점수(0.961)보다 높음
벤치마크에 공개된 상용 파서 결과와 같은 채점 코드로 비교했습니다. 표를 빠짐없이 찾은 정도(F1)는 0.973입니다.
DP-Bench 순위 (높은 순) 순위 엔진 점수 1 Luminir Document Parser 0.962 2 상용 파서 D 0.961 3 상용 파서 D (고급 모드) 0.956 4 상용 파서 E 0.955 5 상용 파서 F 0.907 DP-Bench 공개 리더보드(2026-02-09) 상위 4개와 같은 채점 코드로 잰 Luminir 점수(자체 측정)를 함께 놓았습니다.
이런 일에 씁니다
규정·지침 질의응답
규정집과 업무 지침, 매뉴얼을 조항과 표 구조를 살린 채 RAG 검색에 넣을 데이터로 만듭니다.
쌓여 있는 HWP 문서 정리
수년간 쌓인 한글 문서를 PDF로 바꾸지 않고 한꺼번에 변환합니다. 작업이 중간에 끊겨도 처음부터 다시 돌릴 필요가 없습니다.
통계표·보고서 데이터화
병합 셀이 많은 통계표를 행·열 구조의 HTML 표로 꺼내, 엑셀이나 데이터베이스로 옮기기 쉽게 합니다.
원문 위치 표시
요소마다 원본 위치 좌표가 있어서, AI 답변의 근거가 된 문단을 원본 위에 바로 짚어 보여 줄 수 있습니다.
입출력 형식
입력 INPUT
- 한글HWP, HWPX
- PDFPDF
- 워드DOC, DOCX
- 파워포인트PPT, PPTX
- 엑셀XLS, XLSX
- 이미지PNG, JPG, JPEG
출력 OUTPUT
- HTML제목, 표, 그림을 구분해 브라우저에서 바로 열리는 문서
- JSON요소마다 종류와 위치를 담은 구조화 데이터
- API업로드부터 결과 조회까지 REST API로 연동
GPU 리눅스 서버에 컨테이너로 설치합니다
- 도입 방식
- 온프레미스(기관 서버에 설치), 클라우드
- 설치 형태
- 컨테이너(Docker)
- 운영체제
- 리눅스
- GPU
- NVIDIA GPU
GPU 메모리, CPU·메모리, 저장 공간은 처리할 문서 양과 동시 사용자 수에 맞춰 안내해 드립니다.
자주 묻는 질문 21가지
찾는 답이 없으면 도입 상담으로 물어봐 주세요.
제품 소개
Luminir Document Parser는 르몽이 만든 문서 파서로, 온프레미스와 클라우드 방식을 모두 지원합니다. HWP·HWPX·PDF·워드·파워포인트·엑셀·스캔 이미지 문서에서 제목·본문·표·그림 영역을 찾아 읽기 순서대로 HTML과 JSON으로 바꿉니다. RAG(문서를 검색해 답하는 AI) 시스템에 넣을 데이터를 만드는 데 씁니다.
규정·지침 질의응답, 쌓여 있는 HWP 문서 일괄 변환, 통계표·보고서 데이터화, AI 답변의 원문 위치 표시에 씁니다. 규정집과 매뉴얼을 조항·표 구조를 살려 검색 시스템에 넣거나, 병합 셀이 많은 통계표를 행·열 구조 그대로 엑셀이나 데이터베이스로 옮길 수 있습니다.
성능을 숫자로 확인할 수 있다는 점이 다릅니다. Luminir Document Parser는 한국어 공공문서 벤치마크 KoOCR-Bench를 포함한 공개 벤치마크 4종의 점수를 측정 조건과 함께 공개하고, 기관 문서로 직접 결과를 확인해 드립니다.
문서와 결과
12종 파일 형식을 받습니다. HWP·HWPX, 글자가 있는 PDF와 스캔 PDF, 워드(DOC·DOCX), 발표 자료(PPT·PPTX), 엑셀(XLS·XLSX), 이미지(PNG·JPG·JPEG)를 형식마다 따로 바꾸지 않고 그대로 넣습니다.
네, HWP와 HWPX를 그대로 넣으면 됩니다. 한글 파일의 문단과 표 구조를 직접 읽어 변환합니다. 여러 파일을 한 번에 처리하는 일괄 변환을 지원하고, 중간에 멈춰도 멈춘 곳부터 이어서 처리합니다.
네, 스캔 PDF와 사진도 쪽 이미지에서 표 영역을 찾아 행·열 구조로 읽습니다. 관보·통계표 등 한국어 실문서 604쪽으로 된 KoOCR-Bench에서 종합 0.759를 자체 측정했습니다. 기관 문서로 직접 결과를 확인해 드립니다.
네, 병합 셀이 있는 표는 행·열 병합 정보를 담은 HTML 표로 내보냅니다. 공개 벤치마크 DP-Bench에서 표 구조·내용 일치도(TEDS) 0.962를 자체 측정했습니다.
HTML과 JSON으로 받습니다. HTML은 제목, 표, 그림을 구분해 브라우저에서 바로 열리는 문서이고, JSON에는 요소별 종류, 쪽 번호, 읽기 순서, 위치 좌표가 담깁니다(엑셀은 시트와 셀 범위). REST API로 업로드부터 결과 조회까지 연동할 수 있습니다.
빼지 않고 종류를 표시해 함께 냅니다. 머리말, 꼬리말, 쪽 번호가 따로 표시돼 있어 검색 데이터에서 빼고 싶으면 쉽게 걸러낼 수 있습니다.
PDF·스캔 문서의 수식 영역은 LaTeX(수식 표기 형식)로 읽습니다.
네, 요소마다 쪽 번호와 위치 좌표가 있어 원본 문서 위에 해당 영역을 표시할 수 있습니다(엑셀은 시트와 셀 범위). KoOCR-Bench의 요소 위치 좌표 점수는 0.976입니다(자체 측정).
정확도
각 벤치마크가 공개한 데이터와 채점 코드를 그대로 써서 르몽이 직접 측정한 자체 측정값이며, 측정 조건은 벤치마크 상세 페이지에 공개합니다.
한국어 공공문서 벤치마크 KoOCR-Bench(관보·통계표·보고서 등 604쪽)에서 종합 0.759를 자체 측정했습니다. 공개 리더보드에 오른 설치형 엔진 중 가장 높은 점수입니다.
네, 쪽 전체에서 영역을 먼저 찾고 읽기 순서를 정한 뒤 영역별로 읽습니다. 영어 문서 200쪽으로 된 opendataloader-bench에서 읽기 순서 점수 0.944를 자체 측정했습니다.
설치와 보안
두 방식을 모두 지원합니다. 온프레미스는 기관 서버에 설치해 인터넷이 끊긴 폐쇄망에서도 쓰고, 클라우드는 서버를 따로 마련하지 않고 르몽 서버에서 처리합니다. 기관 보안 정책과 문서 양에 맞춰 안내해 드립니다.
NVIDIA GPU가 있는 리눅스 서버와 컨테이너(Docker) 실행 환경이 필요합니다. 인식 모델까지 기관 서버에 함께 설치하므로 외부 AI 서비스 없이 내부망에서 동작합니다. 서버 세부 사양은 처리할 문서 양과 동시 사용자 수에 맞춰 안내해 드립니다.
온프레미스 방식은 레이아웃 분석과 인식 모델을 기관 서버에 함께 설치해 문서를 기관 서버 안에서 처리합니다. 외부 AI 서비스 없이 내부망에서 동작합니다. 클라우드 방식은 문서를 르몽 서버에서 처리합니다.
네, 관리자·사용자 권한 구분, 원본 문서 암호화 저장, 문서 업로드·조회·내려받기·삭제 감사 기록을 지원합니다.
REST API로 연동합니다. 파일 업로드, 변환 진행 상황 확인, 결과 조회를 API로 할 수 있어 기관의 검색 시스템이나 RAG 시스템에 붙일 수 있습니다.
네, 여러 파일을 한 번에 넣는 일괄 변환을 지원하고, 중간에 멈추면 멈춘 곳부터 이어서 처리합니다. 처리 시간은 기관 문서로 직접 측정해 드립니다.
도입
도입 상담 → 기관 문서로 결과 확인 → 계약과 설치·연동 순서로 진행합니다. 상담에서 문서 종류와 양, 서버 환경을 확인하고, 기간과 조건을 안내해 드립니다.
- 메일
- support@lemong.ai
기관명, 문서 종류와 양, 서버 환경을 적어 주시면 빠르게 안내해 드립니다.